Claude Code는 꼭 Anthropic 서버에 붙어야만 동작하는 것은 아니다. Anthropic Messages API 형식으로 응답하는 서버만 있으면 어디든 붙는다. 이 점을 이용해 맥스튜디오(Mac Studio, 64GB이상 권장)에서 로컬 모델로 Claude Code를 구동했다. 구동 과정은 API 비용도 외부 전송도 없다(웹 검색만 예외).
ㅇ원리
claude CLI ──(Anthropic /v1/messages)──▶ oMLX :8000 ──▶ SuperQwen3.8-27B (MLX) └──(MCP over HTTP)──▶ SerpApi (웹 검색 / 소량 무료)
- API 호환: MLX 서빙 서버인 oMLX가 OpenAI 형식과 함께 Anthropic 형식 엔드포인트도 제공한다. ANTHROPIC_BASE_URL만 로컬로 바꾸면 해당 LLM서버를 호출해서 작동한다. OpenAI 호환방식과는 약간 차이가 있으니, vllm같은 다른 서버 환경을 사용한다면 AI와 추가로 상의해보자.
- Tool Call 호환: Claude Code의 파일 읽기, 편집, 셸 실행은 전부 tool call이다. 서버가 모델의 Tool Call 출력(Qwen은 XML 변형 포맷)을 Anthropic의 tool_use 블록으로 변환해 주면 해당 처리가 문제없이 가능하다. 따라서 이것은 oMLX의 변환지원 여부를 확인하면 되고, oMLX는 이를 잘 지원한다. - 검색 보강: 내장 WebSearch는 Anthropic 서버에서 실행되는 도구라 로컬에서는 동작하지 않는다. 이를 막고, SerpApi의 MCP 서버를 대신 붙였다. 다른 MCP서비스를 이용해도 상관없다.
1. 모델 서버 띄우기
별도 venv에 oMLX를 설치하고, 모델을 ~/.omlx/models/ 아래에 둔다. 디렉터리 이름이 곧 모델 ID다.
상시 구동은 LaunchAgent로 등록한다. SuperQwen3.8-27B 8bit은 약 28GB가 상주하고, MTP(추측 디코딩) 드래프터를 붙이면 코드 생성이 약 30 tok/s 나온다. --no-hf-cache를 빼면 HF 캐시의 모든 모델이 목록에 노출된다.
2. ~/.zshrc에 설정 등록
claude로 기존 실행은 그냥 두고 claude-local 명령을 셋팅해서 필요할때 local로 붙도록 한다. mcp를 통한 웹검색도 따라서 claude-local일때말 활성화 한다. 궣난은 bypassPermissions를 이용한다. auto mode는 제대로 작동하지 않기 때문이다.
- 모든 모델 호출을 같은 모델로 매핑: Claude Code는 내부적으로 opus, sonnet, haiku와 서브에이전트용 모델을 따로 호출한다. 하나라도 빠지면 존재하지 않는 모델 ID로 요청이 나가 에러가 난다. - 환경변수를 함수 안에만 설정: export하지 않았으므로 평소의 claude는 그대로 Anthropic에 붙는다. claude-local로 실행한 세션에만 적용된다. - API 키는 더미: 로컬 서버는 키를 검증하지 않는다. 다만 값이 비어 있으면 로그인 절차로 빠진다. - DISABLE_NONESSENTIAL_TRAFFIC: 텔레메트리와 업데이트 확인 같은 외부 호출을 끈다. - bypassPermissions: 매 도구 호출의 승인 프롬프트를 없앤다. 로컬 모델은 느려서 프롬프트마다 흐름이 끊기는 것이 특히 불편하다. 다만 모델이 셸 명령을 확인 없이 실행하므로 신뢰하는 작업 디렉터리에서만 써야 한다.
serpapi 키는 ~/.zshrc에 export SERP_API_KEY=...로 두면 ${}로 확장된다. --mcp-config로 넘기므로 로컬 세션에서만 활성화된다. 모델 입장에서는 MCP 도구도 일반 tool call과 같아서, "검색해 줘"라고 하면 알아서 호출한다. 검색 쿼리만은 SerpApi로 나간다.
4. 사용
아래와 같이 claude code 실행시 "claude-local"이라고 입력해서 실행한다.
$ claude-local # 대화형 $ claude-local -p "이 레포 구조 요약해줘"
써 보니
- 파일 탐색, 수정, 테스트 실행 같은 일상 에이전트 작업은 충분히 된다. Tool Call 벤치에서도 Qwen 계열이 안정적이었다. - Claude Code는 시스템 프롬프트와 도구 정의만 수만 토큰이라 첫 턴이 길다. 27B 밀집 모델은 프리필이 약 100 tok/s라 체감 대기가 있다. 이후 턴은 프롬프트 캐시 덕에 빠르다. - thinking이 길어지는 모델은 서버 쪽에서 thinking_budget을 걸어야 턴이 끝난다. - 복잡한 설계나 장기 추론은 여전히 본가 Claude가 낫다. 민감한 코드, 오프라인, 반복 작업은 로컬로, 나머지는 claude로 나눠 쓰는 방법도 있다.
5. 기타
claude code를 로컬로 실행하기 위해서는 tool call 호환, web fetch등의 기본 툴 이용, auto mode의 대안 탐색 필요가 중요하다. 그리고 claude code 버전별로 형태가 달라질 수 있으니 실행시 오류는 claude code와 상의할 수 있다. 또한 여러 agent가 구동되면 토큰처리도 병렬이 필요하므로, 충분한 용량의 메모리가 필요한 부분은 고려가 필요하다.
Anthropic / OpenAI / Google 의 LLM 모델들을 쓰면서 우리는 살아가게 되었다. 그리고 limit에 걸리고 장애에 시달린다거나 개인정보를 밖으로 보내고 싶지 않으면, 집에서 한번 고급 사양 PC를 사서 돌려보면 어떨까? 라는 생각을 하게 된다. 이 글은, 그런 분들을 위한 글이다.
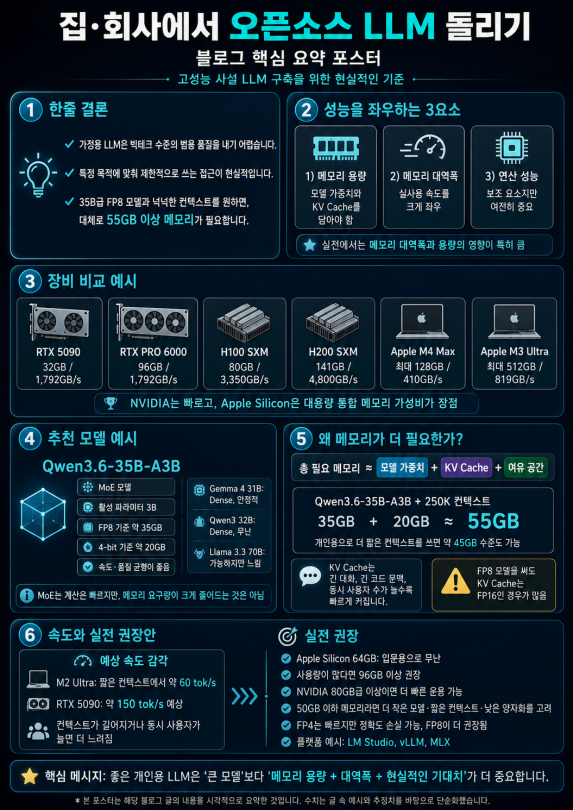
0) 결론은, 여러분의 가정용 LLM은 빅테크의 품질을 낼 수는 없다. 장비 체급이 너무 다르기 때문이다. 그래서 제한된 용도로만 검토해야 한다.
빅테크의 최근 모델은 파라메터 크기가 이미 2,000B(2T) 이상을 넘어섰다고 알려져있다. GPU의 빠른 메모리 공유를 위해 연결했으며, 입력 정보 제한 길이(Context Length)가 1백만(1M) 토큰에 육박한다. 그리고 이는 수억원 이상의 고가 장비로만 달성할 수 있다. 따라서 가정용은 특별한 목적에서 낮은 성능을 감안하고 접근되어야 맞다. 그리고 범용적인 고성능을 원한다면 주저없이 빅테크에 LLM API 요금을 싸게 지불할 방법을 찾는 것이 더 경제적이다. 하지만 어디까지 할 수 있는지는 알아보자. 여기서는 오픈소스 경량 수준급 모델 정도 사용하려면, GPU 메모리 대역폭이 어느정도 되면서 용량은 64gb이상 확보하라고 이야기하고 싶다.
1) LLM을 돌리는 장비에 대한 기본 이해가 필요하다.
지금 우리가 사설로 LLM을 돌리는 방법은 크게 NVidia GPU를 고사양 PC에 장착하거나, 애플 맥의 애플 실리콘(M시리즈)에서 실행하는 방법 2가지가 있다(AMD계열 장비는 잘 모르겠다). 이 장비에는 메모리 대역폭과 연산능력, 용량이라는 3가지 축으로 LLM 구동 성능이 결정된다. 그중 메모리 용량과 대역폭이 중요하고, 아래가 당신이 확보할 수 있는 장비의 그것이다.
애플 실리콘의 경우는 CPU/GPU 메모리 구분이 따로 없는 통합메모리인 점을 고려할 필요가 있다. NVidia RTX GPU 일부 모델은 NVLink라는 브릿지로 연결해서 메모리를 고속으로 공유해서 쓰는 효과를 낼 수 있으나, 가정용은 RTX 3090 정도만 지원한다고 알려져있다(아래 5090은 불가)
회사
모델명
코어정보
메모리정보
메모리 대역폭
NVIDIA
GeForce RTX 5090
21,760 CUDA cores
32GB GDDR7
1,792GB/s
NVIDIA
RTX PRO 6000
24,064 CUDA cores
96GB GDDR7
1,792GB/s
NVIDIA
H100 SXM
16,896 CUDA cores
80GB HBM3
3,350GB/s
NVIDIA
H200 SXM
16,896 CUDA cores
141GB HBM3e
4,800GB/s
NVIDIA
B200 / DGX B200
?
180GB HBM3e per GPU
8,000GB/s per GPU
Apple Silicon
M1 기본형
7~8-core GPU
8GB, 최대 16GB unified memory
약 68.3GB/s
Apple Silicon
M4 기본형
10-core GPU
16GB~32GB unified memory
120GB/s
Apple Silicon
M2 Pro 기본형
16-core GPU
16GB~32GB unified memory
200GB/s
Apple Silicon
M4 Max 기본형
32-core GPU
36GB~128GB unified memory
410GB/s
Apple Silicon
M3 Ultra 기본형
60-core GPU
96GB~512GB unified memory
819GB/s
이 표를 보는 방법은, 메모리 대역폭에 집중하는 것이다. 코어 수도 물론 중요하지만, 대부분 이 대역폭이 성능을 결정한다. 그래서 보면, NVidia GPU가 애플 실리콘보다는 빠르다. NVidia 5090을 M3 Ultra와 비교해보면, 아주 단순하게는 2배 정도 토큰 생성이 빠르다고 유추해볼 수 있다. 물론 애플실리콘은 통합 메모리를 통해 용량을 저렴하게 제공한다는 점은 장점이다. 실제로 1천만원을 투자했다고 했을때는 M3 Ultra는 메모리가 96GB이상을 얻을 수 있는 점이 RTX 5090 32GB대비 큰 장점이다. 하지만 대역폭은 낮다.
가격을 대략 보면 RTX 5090이 1장에 600만원 기준, M3 Ultra 기본형은 1,000만원 정도 바라볼 수 있다. 대개 애플장비에 대해서는 그래서 가성비로 접근되는 부분이 존재한다. 다소 느리지만, 대형 모델을 올릴 수 있다.특히 독자적으로 쓴다고 하면(동시사용자 거의 없는 경우) context length가 길지 않는 한 성능 저하도 견딜만하다. 다만 동시사용자가 생기는 회사인 경우나 긴 context length를 처리한다면 고대역폭의 메모리 제공이 필요하다.
2) 어떤 오픈소스 모델을 올려야 하지?
아래는 artificialanaysis.ai 점수 기준으로 claude에게 애플 실리콘 64gb 메모리 기준으로 추천받은 모델의 점수 순서이다. 순위는 늘 바뀌겠지만, 26년5월 현재는 Qwen3.6-35B-A3B를 추천하고 있다. 보유 메모리가 128gb로 커져도 별로 다르지 않다. 그리고 이 모델들이 가지는 범용적인 특성을 이해할 필요가 있다. 어느정도 cpu작업용 램을 고려하면 애플 실리콘 96gb가 추천된다.
모델명
점수
크기
특성
모델용량
비고
1
Qwen3.6-35B-A3B (Reasoning)
~43
35B
MoE, 3B 활성
4-bit ≈ 20GB
◎ 빠름·여유
2
GLM-4.7-Flash (Reasoning)
~42
~30B급 MoE
MoE
4-bit ≈ 18–22GB
◎ 적합
3
Gemma 4 31B
~39
31B
Dense
4-bit ≈ 19GB
◎ 적합
4
gpt-oss-120b (high)
~33
117B (5.1B 활성)
MoE, native MXFP4
~61GB
△ 한계초과, 비권장 / 약 2 tok/s
5
Qwen3 32B (Reasoning)
~30(v4)*
32B
Dense
4-bit ≈ 18GB
◎ 적합
6
GLM-4.6-Air / GLM-4.5-Air
~30
106B, 12B 활성
MoE
4-bit ≈ 58–60GB
△ 빠듯함
7
Qwen3-Next-80B-A3B (Reasoning)
~27
80B, 3B 활성
MoE
4-bit ≈ 45GB
○ 적합·빠름
8
gpt-oss-20b (high)
~25
21B, 3.6B 활성
MoE, MXFP4
~12GB
◎ 적합
9
Llama 3.3 70B
~20
70B
Dense
4-bit ≈ 40GB
○ 가능하나 느림 / 약 5 tok/s
10
Mistral Small 3.x 24B
~18
24B
Dense
4-bit ≈ 14GB
◎ 적합
*Claude의 답변 정리본('26.5월)
a) 모델의 가중치 크기를 보면 Qwen3.6-35B-A3B는 35B(350억)다. 이는 정확히는 모델이 가진 신경망 가중치의 개수다. 350억개의 가중치로 곱하고 더하는 연산이 필요하다. 그리고 이 크기는 GPU 메모리를 얼마나 차지하느냐로 직결되는데, 여기서는 양자화가 관련이 있다
b) 양자화(Quantization)는 이 가중치 소수값을 한 개당 얼마의 크기로 저장하는가인데, FP16(Floating Point 16 bits)이 통상 학습할 때 사용되는 값이다. 이를 FP8(8 bits), FP4(4 bits)식으로 압축되며, FP8 기준으로 가중치 모델크기와 용량이 변환하기 편하게, 동일 숫자 자리수로 떨어진다. 즉 35B 모델 크기를 FP8 양자화 사용시에는 35gb의 GPU 메모리를 차지한다.
c) 양자화는 bit 수가 작을수록, LLM답변 정확도가 희생된다. 통상 FP4(4 bits)형태의 모델이 크기는 작지만, 전문가들은 6 bits이상을 추천하기도 한다. NVidia가 특정 하드웨어 이득을 받을 수 있는 FP8을 추천하는 이들이 많다. 그러면 이제 기억해보자. 모델의 가중치 개수(크기)를 무난하게 FP8로 양자화하면 동일한 크기로 쉽게 환산할 수 있다고 했었다. 바로 당신이 필요한 최소한의 GPU 메모리는 그래서 Qwen3.6 35B의 경우 35gb이다. 가중치를 메모리에 올려야 부동소수점 연산을 할 수 있다. 물론 KV-Cache를 위해서 더 필요한데, 일단 최소치가 이렇다.
d) 그 다음 흥미로운 것은 연산 속도이다. MoE(Mixture of Experts)라는 방식은, 모델 크기가 커도, 실제로는 일부분만 선택적으로 활성하하여 계산하는 방식으로 속도를 빠르게한다. Qwen3.6-35B의 뒤에 붙은 A3B는 그렇게 3B만 Activation된다는 의미다. 그러면 35B 원래 모델 대비해 거의 12배 쯤 빠를 수 있지 않을까 기대를 하게 된다. 하지만 속도는 그렇다고 해도 메모리 요구량은 줄지 않는다.
그래서 위 표를 통해서 우리는 Qwen3.6-35B A3B가 FP8로 양자화해도 35gb의 GPU메모리를 일단 점유하고, 다른 면에서는 MoE모델이라 다행히 3B정도만 활성화되서, 가중치 전체가 사용(dense모델이라 구분해서 부른다)되는 다른 모델에 비해 빠르다는 것을 알았다.
3) GPU 메모리는 그러면 모델 적재 용도 외에 어떤 용도로 더 필요할까?
이제 Context Length라는 것을 이해할 필요가 있다. 이를 테면 코딩을 하는 AI는, 앞에 내가 코딩하던 코드를 꽤 길게 보면서 작업해야할 필요가 있다. 그래서 얼마나 많은 토큰 입력을 이어서 처리할 수 있는가? 바로 이 Context Length라고 불리는, 끊기지 않고 처리가능한 최대 토큰 길이다. 이 길이가 길수록, LLM은 더 복잡한 말을 알아듣고 처리할 수 있다.
통상의 대화는 8K(8,192개 토큰)정도면 충분하지만, 빅테크의 최신 모델, 예컨데 Opus 4.8의 경우는 1M(1백만)토큰을 처리할 정도로 길게 처리한다. 엄청난 길이다. 책 두어 권을 앞에다가 넣어도 다 처리할 수 있다.
이런 긴 대화를 처리할 때면, 불행히도 매 토큰을 처리할때마다, 이 전체 신경망 연산값의 일부분 snapshot이 계속 필요하다. 예컨데 Qwen3.6 35B의 경우에는 한 토큰을 돌리면 대략 80KB(킬로바이트)정도의 트랜스포머내 KV연산값이 필요하다고 한다. 토큰을 이어서 돌릴 때마다 이 값을 계속 저장해야 한다. 25K의 토큰을 처리하려면 필요한 KV연산값은 2GB(=25K*80KB)만큼이 필요하다. 250K면 20GB가 나온다.
이런 저장값을 바로 KV Cache라고 한다. Transformer의 Attention을 위해서, 처음 토큰부터 최근 토큰까지의 매 토큰 처리시마다, 각 신경망 연산값의 일부를 계속 가지고 있는 것이고, 이것도 다양한 방법으로 양을 줄이긴 하지만(영역 일부를 생략하고 압축하고 등등), 꽤 많은 양이 필요하다(Qwen3.6도 이 간소화를 시켜서 그나마 작다고 한다). 그러면 만약에 이 장비에 동시에 여러명이 작업을 한다면? 역시 그 동시 사용자 만큼 저 KV Cache공간이 필요하다. 어마어마한 양의 GPU 메모리가 필요한 셈이다.
그래서 Qwen3.6-35B A3B를 메모리에 올려서 250K 토큰을 처리한다고 하면 35GB에다가 20GB가 추가로 필요해서 55GB가 필요하다. 물론 몇가지 작업을 위해 조금더 필요하고, 2명의 계산을 동시에 한다면, 20GB가 추가로 필요하므로 75GB가 필요해지게 된다. 이렇게 메모리 소요가 많기 때문에 메모리 대역폭이 굉장히 중요해지면서, 용량이 많이 필요하게 되는 것이다. context length 와 동시 사용자수, 그리고 모델 용량에 따라 필요한 메모리가 곱하기로 올라간다.
하지만 개인용이므로 20GB정도만 더 잡아보면 25GB정도의 메모리가 필요하다는 것을 알 수 있다. 여기서 참고할 것은 이 KV Cache는 MoE라고 해서 잘 줄어들지 않는다는 사실이고, KV Cache는 통상 양자화에 인색하다는 점도 주의가 필요하다. FP8 양자화 모델을 로딩해도 KV-Cache는 FP16으로 처리하는 경우가 흔하다. 각 토큰의 처리에 대한 값이므로, 너무 압축하면 계속 연결되어 계산되면서 오류가 확산되기 때문에 일부러 FP16을 유지하는 경우가 많다고 한다.
4) 그래서 돌려보면 얼마의 토큰이 나와요?
대략 모델과 메모리 용량이 가늠되어서 장비가 준비되었다면, 거의 메모리 대역폭으로 속도가 결정된다. M2 Ultra기준으로 길이가 짧은 2K이하 토큰 길이면 초당 60토큰(한글은 대략 한 글자, 영어는 접미사/접두사 정도 단위다) 정도처리가 예상된다. RTX 5090이라면 초당 150토큰 정도 나올 것이라고 예상된다. 토큰 길이가 더 길어지면? 이제 조금씩 느려질테고, 동시 사용자가 생기면 제약이 될 수 있다.
ollama가 기본 지원하는 모델은 4 bits 양자화가 많다. 대개 FP4에 FP16 KV Cache를 사용한다. 그러면 FP8대비 처리 속도는 2배가 될테지만, 정확도가 불안해지겠다. 원래 대개의 모델은 FP16으로 학습되기 때문에, 정확도 손실을 피하고 싶다면, 모델 제작사에서 명시적으로 4bits를 추천하지 않는한 8bits을 선택하라고 권고하는 이가 많다.
ollama 대신 lmstudio, vllm을 모델 구동 플랫폼으로 사용하는 이유가, 이런 8bits, 6bits의 양자화 모델을 고르기가 쉽기 때문이다. 애플실리콘이라면 최적화된 mlx로 구동도 좋다.
5) 기타
사설 LLM을 운영한다면, 아이러니하게도 claude code나 codex를 설치해서 상의해가면서 튜닝하는 것이 거의 절대적이다. 모두 전문가가 아닌 경우가 많기 때문이다. 아래를 참고한다.
a) 자신의 사양을 이야기하고 artificialanalysis.ai 기준으로 어떤 목적의 점수대로 나열해 달라고 하면 나열해준다. 거기서 고른다
b) 속도가 중요하면 역시 MoE가 답이다. MoE가 아닌 모델은 MoE에 비해 몇배 이상(Activation 비율만큼) 느려짐을 각오해야 한다.
c) ollama, lmstudio, vllm, mlx 의 선택도 역시 AI와 상의하는 것을 추천한다. 자신의 OS나 장비에 따라서 추천해 줄 것이다
d) Qwen3.6 같은 모델들은 이미지 처리도 되므로 필요성에 따라 같이 염두해두면 좋다. 대부분 이미지도 같이 지원되며, mlx의 경우 별도 mlx 이미지 처리용 서버를 같이 설치를 하면 처리도 가능하다(멀티모달이다)
e) FP8로 양자화되면, 실제 계산할때 FP16으로 바꿔야 하는 것 아닐까? 맞다. 하지만 H100같은 GPU는 FP8로 처리하는 기능이 H/W상으로 지원된다. 따라서 여러가지 궁금증은, 각 장비별로 AI와 상의하여 답을 얻으면 자신에 맞는 최적화가 가능하다
6) 마무리
결론을 내려보면, 여러분은 64gb이상의 GPU 메모리와 어느정도 수준 이상의 메모리 대역폭을 확보해야, 현행의 수준급 경량형(35B수준 FP8기준) 오픈소스 모델을 구동할 수 있다. 조금 느림을 감내한다면 dense모델을 선택하고 정확도 추가 향상이 가능하다. 더 이하의 모델들은? 아마도 높아진 여러분의 LLM에 대한 기대치를 만족시키기 어려울 것이다.
a) 애플실리콘의 64gb 모델을 사서 Qwen3.6-35B-A3B를 운영하면 그나마 가장 무난할 것이다. LLM사용량이 높다거나 cpu 사용량 일정 수준 이상 된다면 96gb이상을 추천한다.
b) 여러분이 서버급 NVidia GPU를 사용할 수 있다면 80gb이상의 GPU를 운영하거나, NVLink같은 것으로 연결하여 메모리를 확대 사용이 가능할것이다. 그러면 더 빠르게, 고대역폭 메모리를 통해 동시 사용자도 그나마 원활하게 수용할 수 있다.
c) 만약 여러분이 50gb이하의 GPU메모리만 사용가능하다고 하면, 그 때는 낮은 사양의 모델을 짧은 Context Length나 낮은 양자화 수준(4bits)로 쓸 수 밖에 없을 것이다. 이때는 정확도 희생이 되거나 잘 튜닝된 신중한 방식의 양자화가 필요하다. 자신에게 필요한 context length나 필요한 목적에 특화된 소형 모델을 선택해서 실제 필요한 성능이 나오는지 확인 후 사용이 필요하다.
Andrej Karpathy가 주장한 이후로, LLM Wiki라는 방법론이 확산되었다. 개념 자체는 단순하다. 내가 어떤 원천 정보를 확보하면, 그것의 메타 정보를 LLM을 이용해 정리해주며 문서를 저장해나가는 것이다.
이를 테면 그 문서가 어떤 내용인지 요약본을 확보하고, 무엇을 다루는지 분류하고, 기존 어떤 문서가 연결되어 있는지 등을 같이 정리한다. 그리고 지식이 필요할 때가 되면 그 메타정보와 그리고 필요시 원본을 읽어가며 소유주의 질문에 답하면 된다. 그리고 이 작업은 LLM이 진행하게 하는 것이 핵심이다.
사실 방대한 문서를 AI로 다루기 위한 RAG라는 기존 방법이 있지만, 이 RAG는 아쉬움이 많았다. 단지 검색을 확장한 개념이었기 때문에, 중간에 놓치는 것이 있었다. 하지만 LLM Wiki는 필요한 것들에 대한 메타 정보를 LLM이 생성해주기 때문에, 이러한 소실이 훨씬 줄어든다. 물론 대신 토큰을 많이 생성하고, 속도는 더 느리다. 마치 대리하는 사람이 직접 정보를 뒤져 찾아주는 듯한 방법론이기 때문이다.
그러면 어떻게 하면 될까? 여기서는 claude code는 설치되었다고 가정하자.
1) LLM Wiki의 저장소 역할을 할 Obsidian을 설치해준다.
Obsidian은 맥과 윈도우 모두를 지원하는 무료 툴로, 온라인 sync가 필요할 시에는 유료다. 하지만 무료 기능으로 충분하다. Obsidian이 무엇이냐고 묻는다면, md(마크다운, AI와 인간이 읽기 쉬운 약식의 문서 형식이다)형태로 문서를 저장하고 관리하는 툴이라고 보면 된다. md에 기반하는 LLM 도구들과 딱 어울리며, 여러가지 문서들을 열람하고 조회하며 시각화하는 기능도 제공해준다. 본래는 개인 노트나 자료를 정리하는 툴이었지만, md형식의 Wiki역할도 충분히 해낸다.
2) Obsidian CEO가 직접 만들었다는, Obsidian을 이용하는 skill을 설치한다.
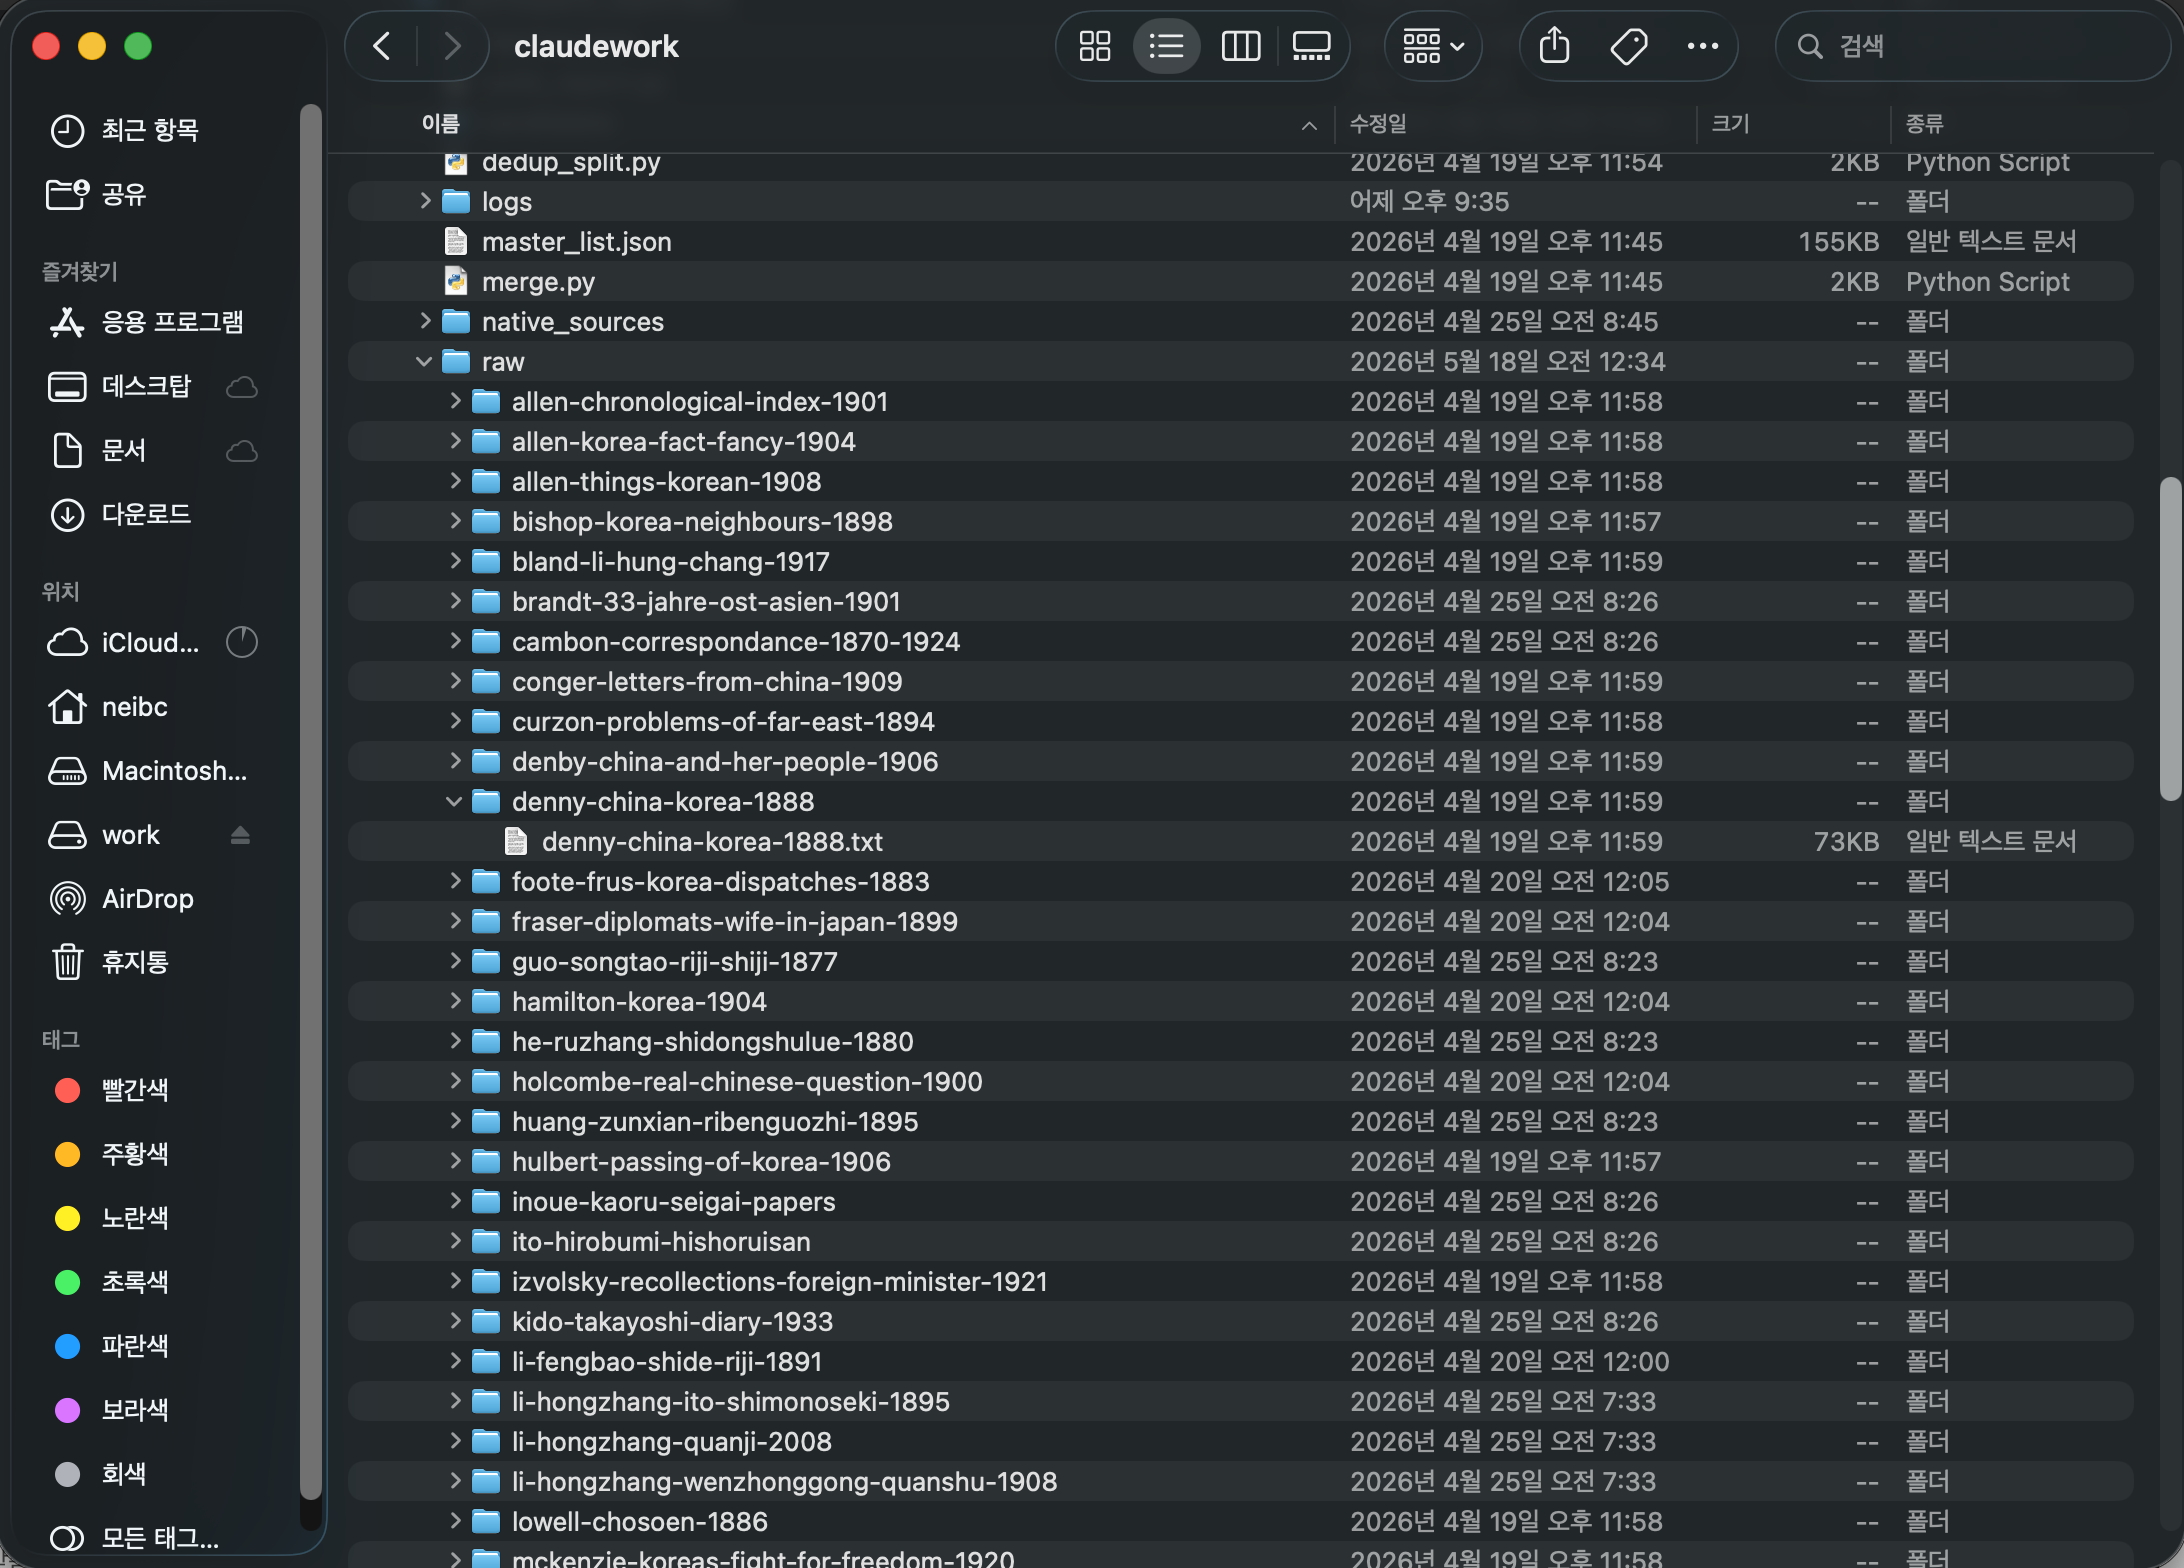
> /harness wiki llm이라는 방법론으로 obsidian의 vault형태로 만드는 하네스를 구성해줘. xxx 폴더에 있는 구한말 역사 원본들을 하위디렉토리까지 탐색해서, 최근 설치한 obsidian skill을 사용해서 진행해. 인물관점으로 잘 정리하고, 용어는 한글을 중심으로 적어주되, 내부적인 다국어 읽기/쓰기 변환 원칙을 마련해서 일관되게 진행하고 다국어를 다룰 수 있게 준비해.
> vault 구성을 진행해
c. 특정 folder에 vault 구성이 완료되고 나면, 이제 질문하고 싶은 것을 claude에 묻는다. 나중에는 vault가 구성된 폴더를 명기해서 질문할 수도 있다.
> vault로 구성한 정보를 바탕으로 아래 질문에 대답해줘 "질문을 적어서 묻는다."
5) 위 "질문"에 대한 답변 예시는 아래와 같다.
아래 답변을 통해서, 이 LLM Wiki가 상당한 수준임을 알 수 있었다(Opus 4.7). 개인적으로는 역사학의 새로운 장이 열렸다고 생각한다. 기존의 사료를 수기로 뒤지던 것에서 훨씬 더 나아갈 수 있고, 다국어 지원도 쉬우며, 무엇보다 각국 사이트의 정보 모으기도 쉽다. 조선왕조실록이나 승정원일기 등과의 매칭도 훨씬 더 쉬워지리라 생각된다. 역사학계는 이제 도서관 사료를 모두 LLM Wiki로 정리하고 조회/검증해야 한다고 생각한다.
a) 박정양의 미행일기에서는 청나라의 압력을 피해서 미국 대통령을 만나는 자주 외교를 행한 것처럼 묘하게 기술이 되어 있고, 선교사 알렌의 기록에는 자신이 사임하겠다고 압박하며 박정양이 청에게 의존하려는 것을 막았다고 적혀있어. 어느 것이 진실일까?
----------
중간 발췌
6. 두 사료의 시각 충돌 — vault가 확인 가능한 한계 내에서의 정리
항목: 청 공사 동행 알현 시도 시점
박정양 米行日記 (사용자 진술): (vault 미확인)
알렌 Things Korean (vault L6206-23): 워싱턴 도착 후 청 공사가 종속국 사절로 소개하겠다고 선언